Corriger la lenteur du listage de dossiers S3 avec NetDrive

Diagnostiquez et corrigez la lenteur du listage de fichiers quand NetDrive monte de grands buckets S3. Limites de l'API S3, cache NetDrive et bonnes pratiques de structure.
Une équipe backend monte un bucket Amazon S3 comme lettre de lecteur Windows via NetDrive pour son pipeline de fixtures CI. Tout fonctionne parfaitement pendant des mois — jusqu’à ce qu’un refactor ajoute 40 000 nouveaux objets de fixtures sous un seul préfixe S3. Le build du lendemain matin se bloque 90 secondes pendant la préparation des tests, en attendant que le dossier de fixtures se peuple dans l’Explorateur. NetDrive n’est pas bloqué : il effectue 40 appels API S3 séquentiels pour énumérer ce seul dossier.
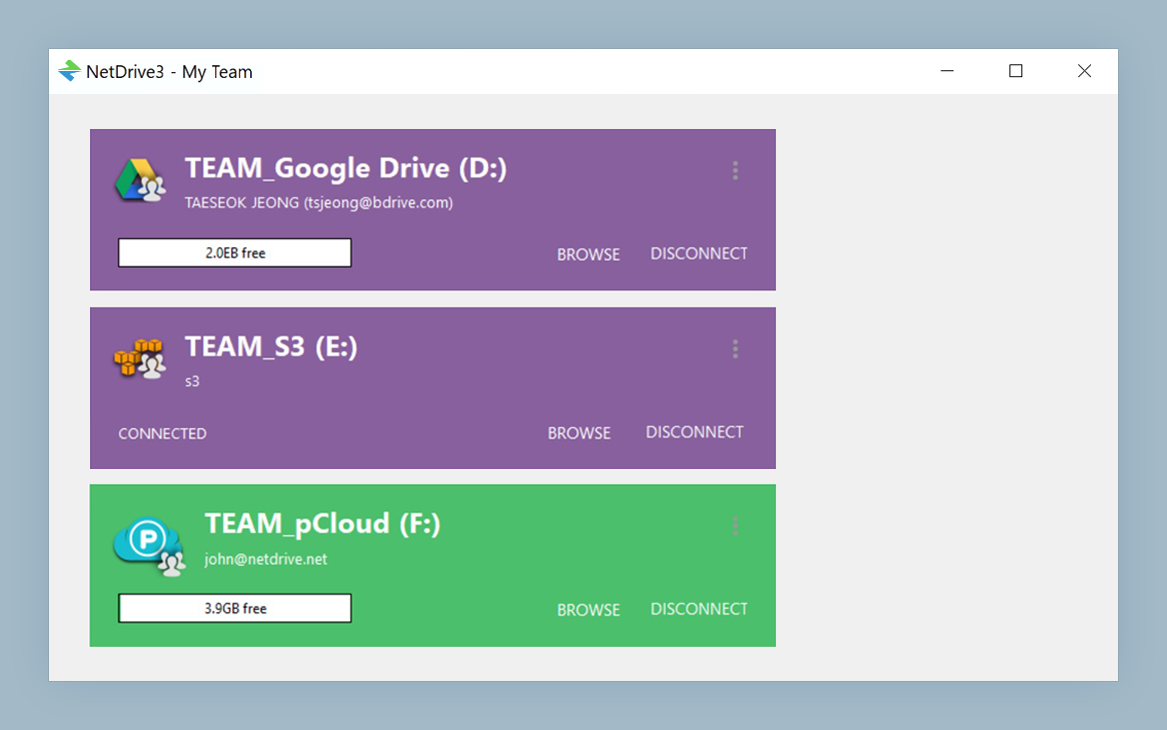
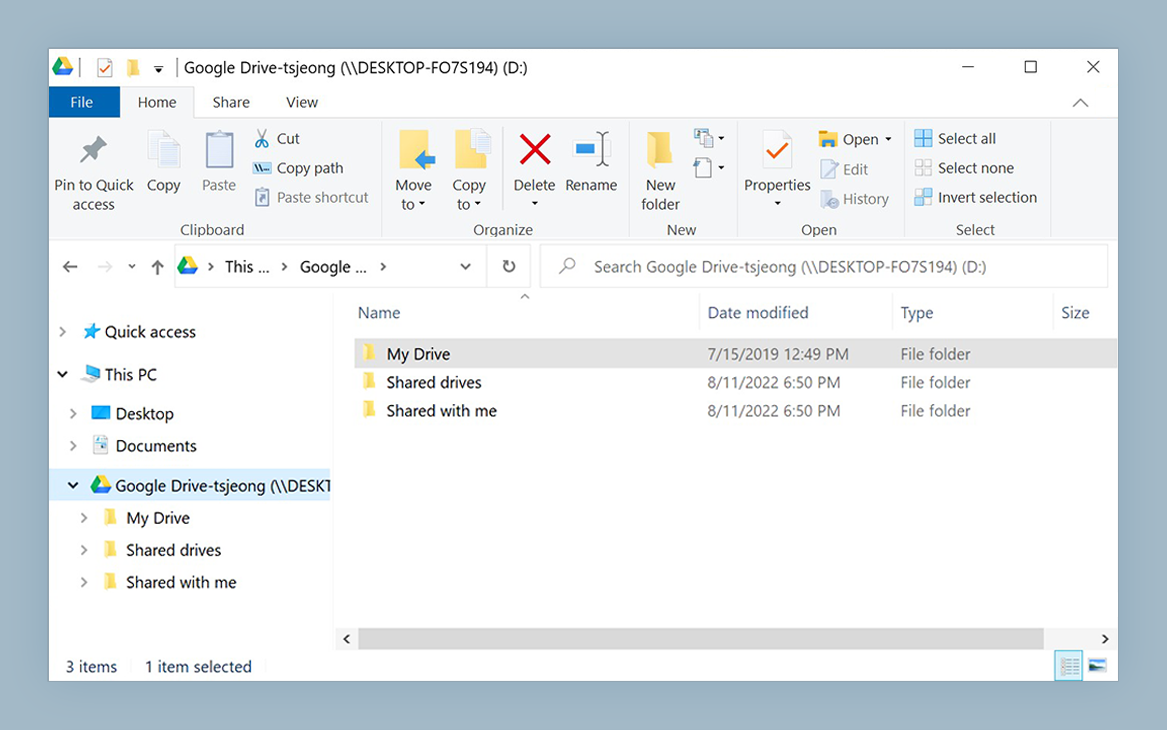
Montez des buckets S3 comme un lecteur natif Windows ou macOS
Avec NetDrive, Google Drive, OneDrive, S3, SFTP, WebDAV et plus apparaissent comme des lecteurs natifs sur Windows et macOS — sans synchronisation ni téléchargement complet.
- Les buckets S3 apparaissent comme D:, E:, ou toute autre lettre de lecteur sur Windows
- Listages de dossiers mis en cache pour un accès répété plus rapide après le premier montage
- Forcez l'actualisation de dossiers spécifiques quand les objets en amont changent
Essai gratuit. Licences à vie et abonnements disponibles.
Pourquoi le listage S3 est plus lent qu’un système de fichiers local
S3 est un stockage objet, pas un système de fichiers hiérarchique. Ce qui ressemble à un dossier nommé fixtures/integration/ est en réalité un préfixe de clé partagé — des milliers de clés d’objets qui commencent par cette chaîne. Il n’existe aucun dossier réel. NetDrive (comme tout autre outil de montage S3, y compris rclone et ExpanDrive) simule des dossiers en appelant l’API S3 ListObjectsV2.
Le hic : un appel ListObjectsV2 renvoie au maximum 1 000 objets. Un préfixe contenant 40 000 clés nécessite 40 appels API séquentiels pour être entièrement énuméré. À 50 ms par aller-retour vers le point de terminaison S3 (raisonnable dans la même région AWS), cela représente 2 secondes de pur overhead API avant que le premier nom de fichier ne s’affiche dans l’Explorateur. Via un proxy d’entreprise ou vers une autre région, ces 40 appels peuvent s’étirer à 30-90 secondes.
Ce n’est pas un bug de NetDrive. C’est le contrat de l’API S3 — le même comportement affecte aws s3 ls, le mode montage de rclone, et tout autre outil listant de grands préfixes S3. La correction se trouve à deux endroits : la façon dont NetDrive met en cache les listages de dossiers, et la façon dont vous structurez votre bucket.
Comment le cache de dossiers de NetDrive réduit l’overhead répété
Après le premier listage d’un grand préfixe, NetDrive met en cache l’arborescence de dossiers localement. La prochaine fois qu’un processus navigue vers D:\fixtures\integration\, NetDrive renvoie le listage mis en cache sans le moindre appel API S3. Ce cache est persistant entre les sessions : après un démarrage à froid, le cache reste chaud depuis le montage précédent, donc le listage au second lancement est instantané même si vous avez redémarré le serveur de build pendant la nuit.
La taille du stockage du cache est configurable jusqu’à 1 To (introduit dans NetDrive 3.16.589). Pour un bucket contenant des centaines de milliers d’objets répartis sur des dizaines de préfixes, allouer plus d’espace de cache garde une plus grande partie de l’arborescence chaude entre les exécutions CI. Ajustez ce paramètre dans les réglages du lecteur, dans Drive Manager.
Le compromis, c’est l’obsolescence. Si un collègue ou un pipeline en amont téléverse de nouveaux objets directement sur S3 — via la console AWS, un autre outil, ou une autre machine — la vue mise en cache de NetDrive ne reflétera pas ces changements avant l’expiration du cache ou un rafraîchissement manuel. Pour rafraîchir un dossier spécifique : clic droit dessus dans l’Explorateur Windows → Refresh. NetDrive relance l’appel ListObjectsV2 pour ce préfixe, met à jour le cache, et renvoie le listage actuel.
Changements de structure de bucket qui réduisent l’overhead de listage
Ces corrections nécessitent des changements dans la façon dont vous organisez votre bucket S3, mais elles profitent à tout outil qui le lit — pas seulement à NetDrive.
Aplatissez les hiérarchies de préfixes profondes. Chaque niveau d’imbrication que vous parcourez déclenche son propre appel de listage. Un chemin comme fixtures/integration/service-a/env-staging/2026/05/ compte six niveaux — jusqu’à six appels API séquentiels avant d’atteindre les objets. Aplatissez-le : fixtures/integration/service-a-staging-2026-05/ stocke les mêmes données avec un seul appel de listage pour atteindre la feuille.
Partitionnez les préfixes à forte cardinalité par période ou catégorie. Si un seul préfixe logs/ contient 80 000 objets répartis sur deux ans de sortie quotidienne, divisez-le en logs/2025/ et logs/2026/. Quand NetDrive liste logs/, il voit deux sous-préfixes en un seul appel API. Naviguer ensuite dans logs/2026/ ne fait qu’un appel supplémentaire pour cette seule année.
Séparez les données chaudes et froides. Gardez les objets activement lus dans un préfixe borné — fixtures/active/ — et archivez les plus anciens vers fixtures/archive/. Les pipelines CI qui montent le bucket entier mais ne lisent que fixtures/active/ listent rapidement ; l’archive froide reste non mise en cache et hors du chemin critique.
Définissez un Root path sur le lecteur. Dans les paramètres de connexion S3 de NetDrive, le champ Root path vous permet de monter un préfixe spécifique comme racine du lecteur. Définissez-le sur fixtures/active et NetDrive traitera ce préfixe comme D:\. Le reste du bucket n’est jamais listé pendant la session de montage — seul le chemin dont votre outillage a réellement besoin.
Vérifiez la région du point de terminaison. Ouvrez la connexion S3 dans Drive Manager et confirmez que la région correspond à la région d’origine de votre bucket. Une requête inter-régions ajoute 50-200 ms par appel API. Sur 40 appels de listage paginés, cela représente 2-8 secondes de latence réseau évitable à chaque ouverture de dossier à froid.
Pour conclure
La lenteur du listage de dossiers S3 est presque toujours un problème de structure de bucket plutôt qu’un problème de configuration NetDrive. La limite de 1 000 objets par appel de l’API S3 est fixe ; ce que vous contrôlez, c’est le nombre d’appels nécessaires pour atteindre les objets dont vos outils ont besoin. Aplatissez les hiérarchies profondes, partitionnez les préfixes à forte cardinalité, définissez un root path pour circonscrire le montage, et laissez le cache de dossiers garder les listages répétés instantanés.
Pour les équipes qui rencontrent des erreurs de permission sur S3 plutôt que des problèmes de performance, voir Corriger l’erreur d’accès refusé S3 avec NetDrive. Si votre pipeline CI utilise Wasabi au lieu d’AWS S3, le même comportement de listage s’applique — voir Monter Wasabi sur Windows avec NetDrive.
— Jay, NetDrive