修复 NetDrive 挂载时 S3 目录列表缓慢的问题

诊断并修复 NetDrive 挂载大型 Amazon S3 存储桶时目录列表缓慢的问题。涵盖 S3 API 限制、NetDrive 缓存设置及存储桶结构最佳实践。
某后端团队通过 NetDrive 将 Amazon S3 存储桶挂载为 Windows 盘符,用于其 CI 测试夹具流水线。数月来运行顺畅——直到一次重构在单个 S3 前缀下新增了 4 万个测试夹具对象。第二天早上的构建在测试准备阶段卡住 90 秒,等待夹具目录在资源管理器中填充。NetDrive 并没有卡死;它只是为了枚举这一个目录而发出了 40 次顺序的 S3 API 调用。
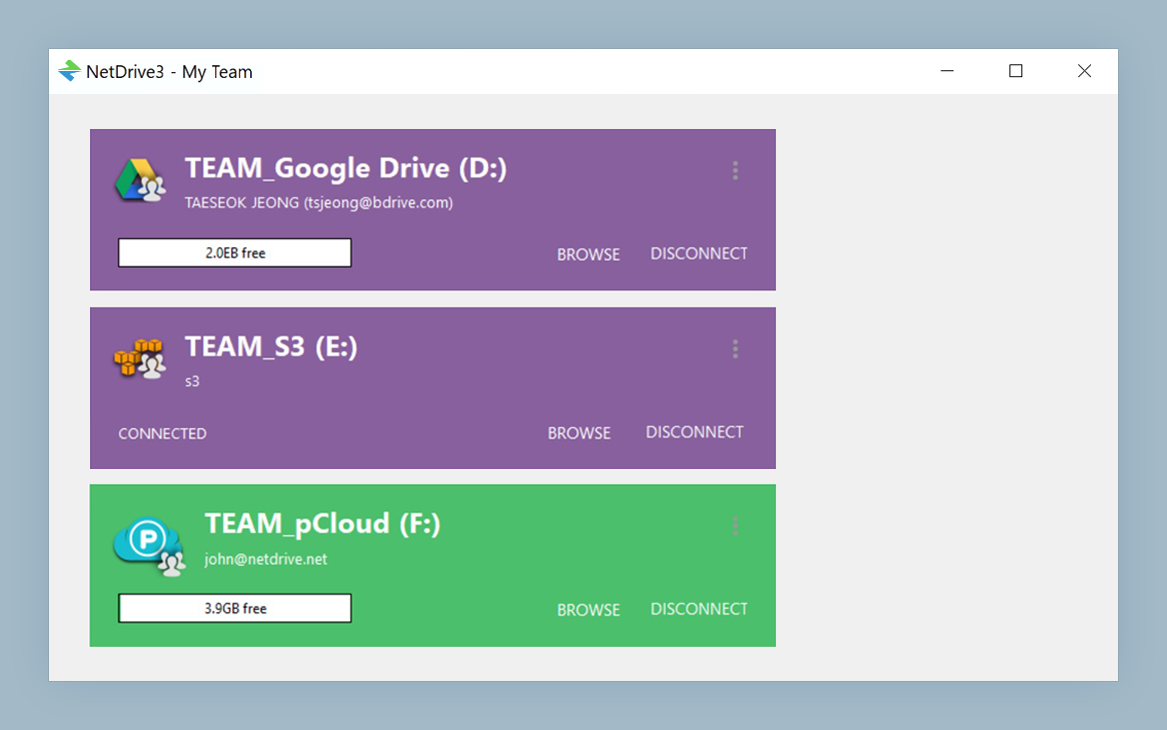
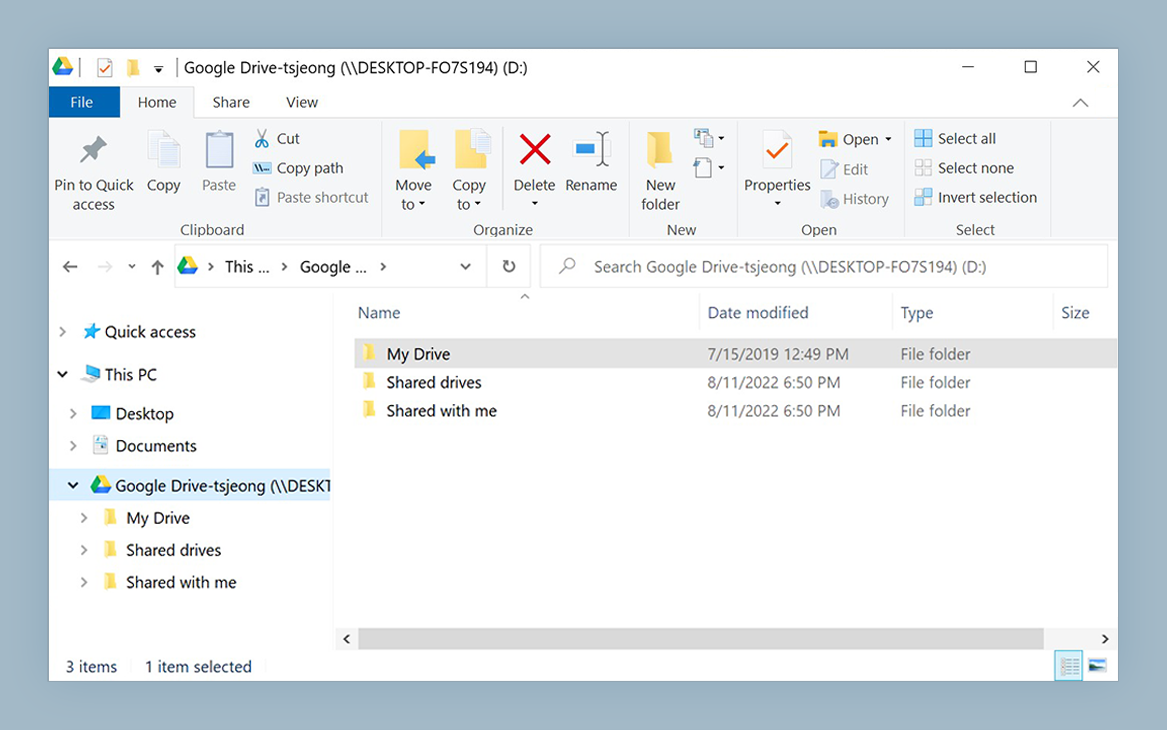
将 S3 存储桶挂载为原生 Windows 或 macOS 驱动器
NetDrive 让 Google Drive、OneDrive、S3、SFTP、WebDAV 等在 Windows 和 macOS 上显示为本地驱动器 — 无需同步,无需完整下载。
- S3 存储桶在 Windows 上显示为 D:、E: 或任意盘符
- 缓存目录列表,首次挂载后重复访问更快
- 当上游对象发生变化时,可强制刷新特定文件夹
免费试用。提供终身与订阅方案。
为什么 S3 列表比本地文件系统慢
S3 是对象存储,而非分层文件系统。看似名为 fixtures/integration/ 的”文件夹”实际上是一个共享的键前缀——只是恰好以该字符串开头的成千上万个对象键。这里并不存在真正的目录。NetDrive(以及包括 rclone 和 ExpanDrive 在内的其他所有 S3 挂载工具)通过调用 S3 的 ListObjectsV2 API 来模拟目录。
问题在于:一次 ListObjectsV2 调用最多只返回 1,000 个对象。一个包含 4 万个键的前缀需要 40 次顺序 API 调用才能完全枚举。以每次往返 S3 端点 50 毫秒计算(在同一 AWS 区域内属合理值),在资源管理器中渲染出第一个文件名之前就要产生 2 秒的纯 API 开销。若经过企业代理或访问不同区域,这 40 次调用可能拉长到 30–90 秒。
这并非 NetDrive 的缺陷,而是 S3 API 的固有约束——同样的行为也会影响 aws s3 ls、rclone 的挂载模式,以及列出大型 S3 前缀的所有其他工具。解决方法体现在两个方面:NetDrive 如何缓存目录列表,以及你如何组织存储桶结构。
NetDrive 的目录缓存如何降低重复开销
首次列出大型前缀后,NetDrive 会在本地缓存该目录树。此后任何进程再次访问 D:\fixtures\integration\ 时,NetDrive 都会直接返回缓存的列表,无需任何 S3 API 调用。该缓存在会话之间持久保存:即使冷启动后,缓存仍保留上一次挂载的内容,因此即便你在夜间重启了构建服务器,第二次运行的列表加载依然是瞬时的。
缓存存储大小可配置,最高可达 1 TB(自 NetDrive 3.16.589 起引入)。对于拥有数十万个对象、分布在数十个前缀下的存储桶,分配更多缓存空间可让更多目录树在多次 CI 运行之间保持”热态”。可在驱动器管理器中该驱动器的设置里进行调整。
代价是数据可能过时。如果同事或上游流水线直接向 S3 上传新对象——通过 AWS 控制台、另一个工具或另一台机器——NetDrive 的缓存视图不会反映这些变化,直到缓存过期或你手动触发刷新。要刷新特定文件夹:在 Windows 资源管理器中右键点击该文件夹 → Refresh。NetDrive 会针对该前缀重新发出 ListObjectsV2 调用,更新缓存,并返回最新列表。
降低列表开销的存储桶结构调整
以下修复需要改变你组织 S3 存储桶的方式,但收益会惠及读取该存储桶的每一个工具——而不仅仅是 NetDrive。
扁平化过深的前缀层级。 你所浏览的每一级嵌套都会触发一次独立的列表调用。像 fixtures/integration/service-a/env-staging/2026/05/ 这样的路径有六层——在到达对象之前最多需要六次顺序 API 调用。将其扁平化为:fixtures/integration/service-a-staging-2026-05/,用一次列表调用即可存储同样的数据并到达叶节点。
按时间或类别对高基数前缀进行分区。 如果单个 logs/ 前缀下存有跨越两年、共 8 万个对象的每日输出,可将其拆分为 logs/2025/ 和 logs/2026/。当 NetDrive 列出 logs/ 时,一次 API 调用即可看到两个子前缀。进入 logs/2026/ 后,仅需再多一次调用即可获取该年份的内容。
将热数据与冷数据分离。 将经常读取的对象保留在一个受限前缀中——如 fixtures/active/——并将较旧的对象归档到 fixtures/archive/。挂载整个存储桶但只读取 fixtures/active/ 的 CI 流水线可以快速完成列表;冷归档数据则保持未缓存状态,不进入关键路径。
在驱动器上设置 Root path。 在 NetDrive 的 S3 连接设置中,Root path 字段允许你将特定前缀挂载为驱动器的根目录。将其设为 fixtures/active,NetDrive 就会把该前缀视为 D:\。存储桶的其余部分在整个挂载会话期间都不会被列出——只列出你的工具真正需要的路径。
核实端点区域。 在驱动器管理器中打开 S3 连接,确认所设区域与存储桶所在区域一致。跨区域请求每次 API 调用会增加 50–200 毫秒。在 40 次分页列表调用中累积起来,每次冷目录打开就会额外产生 2–8 秒本可避免的网络延迟。
总结
S3 目录列表缓慢几乎总是存储桶结构问题,而非 NetDrive 配置问题。S3 API 每次调用 1,000 个对象的上限是固定的;你能掌控的是到达工具所需对象要经过多少次调用。扁平化过深的层级、对高基数前缀进行分区、设置根路径以限定挂载范围,并让目录缓存保持重复列表的瞬时加载。
如果你的团队遇到的是 S3 权限错误而非性能问题,请参阅修复 NetDrive 的 S3 访问拒绝错误。如果你的 CI 流水线使用的是 Wasabi 而非 AWS S3,同样的列表行为依然适用——请参阅在 Windows 上通过 NetDrive 挂载 Wasabi。
— Jay, NetDrive